核心问题: Claude 从 Opus 4.7 开始,将 tokenizer 词表从约 49K 突然压到约 16K。与此同时,GPT、Qwen、GLM、DeepSeek、Kimi 的最新模型仍然普遍维持在 130K–250K。Anthropic 到底在用更长的 sequence 换什么? 本文并不主张“16K vocab 一定更好”。核心假说是:Anthropic 可能在主动把语言建模复杂度从 vocabulary axis 转移到 sequence axis,甚至进一步转移到 latent-depth axis。 如果 Mythos 确实和猜测的一样采用 recurrent / looped Transformer,那么 small vocab 与 looped depth 可能是一组协同设计,而非两个彼此无关的现象。
#1. The 16K anomaly:Claude 为什么逆着行业趋势走?
过去几代主流 LLM 的 tokenizer 演化,大体是在向更大的 vocabulary移动。更大的词表通常意味着更高的文本压缩率、更短的 sequence,以及更少的 autoregressive decoding steps。
已有 scaling-law 工作甚至给出了一个相当直接的结论:模型越大,compute-optimal vocabulary 往往也会随之扩张。比如 Scaling Laws with Vocabulary 对大模型给出的最优词表规模远高于传统 32K/50K 区间。
Claude 却突然走向了另一边。
根据 Sander Land 对 Claude token-count API 的系统逆向研究,Claude 3 到 Opus 4.6 的 tokenizer 规模约为:
而从 Opus 4.7 开始,新 tokenizer 的最佳估计变成:
目前已经重建出约 15.2K 个有直接 witness 的 vocabulary pieces,因此 16,384 是一个相当可信的 slot-level 估计。Reconstructing Claude's tokenizer / On the Biology of Claude's Tokenizer
这次变化远超常规的“小幅调参”,代表着: 接近 3× 的骤降。
更反常的是,Anthropic 同时接受了更长的 token sequence。这份权衡伴随明确代价: 因此真正值得追问的是:
Anthropic 为什么愿意支付更长 sequence、更大 KV cache、更多 autoregressive steps 的成本,来换一个显著更小的输出空间?
1.1 和 2026 年其他旗舰模型相比,16K 到底有多小?
作为对比,其他 frontier/open-weight family 的 vocab_size 大致如下:
| 模型 / 系列 | 公开 vocab size | 相对 Claude 16K | 口径 |
|---|---|---|---|
| Claude Opus 4.7+ / Mythos / Fable | ≈16,384 | 1× | API 逆向重建估计 |
| GPT-5.6 | ≈200,000 | ≈12.2× | o200k_base text tokenizer;physical LM-head dimension 未公开 |
| DeepSeek-V4-Pro | 129,280 | ≈7.9× | 官方 open-weight config |
| GLM-5.3 | 154,880 | ≈9.5× | 官方 open-weight config |
| Kimi K3 | 163,840 | 10× | 官方 open-weight config |
| Qwen3.8 Max | 248,320 | ≈15.2× | 官方 open-weight config |
公开配置来源:Qwen3.8、GLM-5.3/5.2、DeepSeek-V4-Pro、Kimi K3。
这些数字并非完全 apples-to-apples:open-weight 模型的
vocab_size往往包含 reserved / multimodal / special token slots,而 Claude 的 16,384 是 closed model 的逆向估计。GPT-5.6 的约 200K 指公开 text-tokenizer / token-ID 口径,不能直接视为闭源模型未公开、且可能经过 padding 的实际 embedding / LM-head 维度。但即使考虑这些口径差异,16K 与 130K–250K 之间仍然是数量级上的设计分歧,远超几个百分点的 tokenizer 调优。 Qwen3.8 的对比尤其夸张。Qwen3.8 的公开旗舰模型vocab_size=248,320,而 Claude 约 16,384: 换句话说,Anthropic 在一个行业普遍把词表做大的时代,选择了一个大约只有 Qwen3.8 十五分之一的离散输出字母表。
#2. Claude 的 16K 不是普通 BPE 的 16K:从 memorization 到 composition
如果只是把一个传统 BPE tokenizer 从 49K 粗暴压到 16K,结果大概率只是 token 数暴涨、长尾语言恶化,以及代码和多语言压缩率下降。
Claude 的特殊之处在于,Sander Land 的 reconstruction 表明,它的新 tokenizer 很可能已经脱离传统 pairwise BPE,更接近 minimum-piece / PathPiece 风格的 segmentation,并显式利用 boundary information。
这意味着 Claude 已经超越了简单的“少存一些词”,转向更强的 structural factorization。
2.1 一个直观例子:BPE 把边界记进 token,Claude 把边界因子化
现代 byte-level BPE(例如 OpenAI 的 o200k_base)经常直接把前导空格作为 token 字符串的一部分。一个典型例子是:
"The cat sat on the mat"
-> ["The", " cat", " sat", " on", " the", " mat"]
注意这里不是 "cat",而是 " cat":空格本身被 merge 进了 vocabulary piece。于是从词表设计上看,cat、 cat,乃至不同大小写形式都可能成为不同 entries。大词表的一部分容量,实际上被用来记忆这些 surface-form × boundary 组合。o200k example
Sander Land 对 Claude tokenizer 的逆向结果呈现出另一种思路。Claude 会给 word-like span 加上推断出的 begin/end boundary state,他用 ^ 和 $ 来记号。例如:
tokenizers
-> [^token] [izers$]
这里 ^ 表示 begin-of-word,$ 表示 end-of-word;它们只是对逆向行为的记号,不表示输入文本里真的插入了两个字符。更关键的是,这套 boundary mechanism 会“吃掉”词间空格,所以 Claude 不再需要像传统 GPT-style BPE 那样,为同一个 lexical piece 大量保存 "token" 与 " token" 两套版本。On the Biology of Claude's Tokenizer
另一个更能体现 context-dependent structural factorization 的真实例子是:
telecommunications
-> 1 token

telecommunicationsy
-> [^telecommun] [ic] [ation] [sy$]
完整单词 telecommunications 可以匹配一个带有“词首+词尾”状态的整体 piece;一旦后面再接 y,原先的 end-of-word 条件不再成立,tokenizer 就重新组合成四个 pieces。也就是说,Claude 的 vocabulary entry 不只是“一个字符串”,而更像: 可以用一张表更直观地比较 Claude 的新 tokenizer 与传统 byte-level BPE:
| 传统 byte-BPE | Claude reconstruction | |
|---|---|---|
| 边界信息 | 常隐式编码在 " token" 这类 surface piece 中 | 显式/结构化为 begin/end boundary state |
| 分词规则 | pairwise merge hierarchy | 更接近 minimum-piece / PathPiece |
| 词表容量 | 容易为不同 surface variants 分别占 slot | 更强调结构复用与组合 |
因此,Claude 的 16K 并不能简单类比成“把一个普通 BPE 的 merge 次数砍到 16K”。它更像是在先改变 vocabulary 的组织方式,再缩小 vocabulary 的规模。
我更愿意把 Claude 16K 的第一层特征概括为: 也就是:每一个 vocab slot 承担更多可复用的结构,而不是更多被记忆的表面字符串。
2.2 更重要的变化:从 lexical memorization 转向 compositional generalization
如果只把 16K 理解成“更省 vocabulary slots”,仍然低估了这次 tokenizer 重构的意义。
传统大词表 BPE 的一个隐含倾向,是不断把高频字符串 merge 成更长、更具体的 lexical chunks。随着 vocab 变大,越来越多结构会从: 转移到: 例如,一个稀有 identifier、函数名或新组合词,如果刚好命中一个已有 long merge,模型会直接看到一个高度具体的 embedding;如果没有命中,则又会退化成完全不同的分词路径。tokenizer 因而在语言模型之前先做了一层相当强的“字符串记忆”。
Claude 4.7+ 的设计看起来是在主动反方向移动:减少对长 lexical chunks 和 surface variants 的依赖,保留更高复用率的 primitive pieces,再由模型在 context 中组合它们。
可以把这种变化抽象成: 这类设计最可能受益的或许并非普通英文 prose,反倒是那些本身高度依赖字符串结构与组合泛化的任务:
- 代码:变量名、函数名、路径、hash、版本号等不断出现训练集中没有见过的新组合;
- Agent / tool use:JSON keys、schema fields、API names、URLs、命令参数往往是结构化但长尾的字符串;
- 符号与数学表达:模型需要操作组成元素,避免只识别整个字符串 chunk;
- rare / unseen words:primitive composition 可以减少“见过这个完整 token 才会处理得好”的依赖。 潜在收益超出了简单的“token 更细”:更多组合关系可以发生在神经网络内部,减少 tokenizer 的预先固化。
一个更准确的理解可能是:Anthropic 追求的是一个更小、也更可组合的 vocabulary basis。 16K 是结果,structural factorization + compositional generalization 才可能是设计本身。
2.3 更密集的训练信号:少一点 long tail,少一点 under-trained embeddings
这还能缓解另一个大词表的经典问题:rare / under-trained / glitch tokens。类似 SolidGoldMagikarp 的现象说明,大词表天然更容易形成频率极低、embedding 学习不足、语义行为异常的 token。
把 49K 压到 16K 不等价于“每个 token 的训练频率平均提高 3×”——真实 token frequency 是高度长尾的——但总体方向很明确:。
这件事对 input embedding 和 output LM head 都有意义。一个几乎没有被训练过的 vocab entry,不只是 tokenizer 层面的浪费,它还意味着一行低质量 embedding / output weight;而 structural small vocab 可以把更多训练量集中到真正高复用的 primitives 上。
2.4 Anthropic 愿意牺牲 compression ratio,本身就是一个信号
最值得注意的是:Claude 新 tokenizer 并没有让相同文本变得更短,恰恰相反,它会产生更多 token。这意味着 Anthropic 主动接受了: 以及随之而来的更多 backbone forward、KV cache 和 autoregressive steps。
如果目标只是降低 LM-head 参数量或 inference FLOPs,这个 trade-off 并不显然划算:Transformer body 通常比最后一个 vocabulary projection 更昂贵,而 sequence inflation 会把成本重新加回 backbone。
所以一个更自然的推断是:Anthropic 可能认为 tokenizer quality 不应该只用 compression ratio 衡量。 它更在意的可能是:
- primitive 是否被充分训练;
- representation 是否更稳定;
- morphology / boundary 是否可以组合;
- rare string 是否能自然泛化;
- output space 是否更容易学习。 换句话说,传统 tokenizer 常把: 当作非常重要的效率指标;Claude 的设计则像是在说: 到这里,我们已经可以给出一组不依赖 Looped Transformer 假说的解释:structural factorization、compositional generalization、更高 vocab utilization,以及更密集的训练信号。
但这仍然留下一个更深的问题:如果 Anthropic 已经愿意把更多计算从 vocabulary lookup 迁回 sequence model,那么它是否也在更进一步地把计算迁移到 latent depth?这就自然引向下一章。
不过,这一章主要回答了:
Anthropic 如何把 vocabulary 安全地缩到 16K,以及为什么这种缩小本身可能改善 learning。 接下来才讨论一个更激进的可能性: 16K 是否还和 sequence/depth architecture 存在协同?
#3. 一个统一视角:Vocabulary、Sequence、Depth 三条轴
理解这个设计时,把语言模型的计算拆成三条轴会比单独讨论 tokenizer 更有用:
3.1 Vocabulary axis:把结构预先“编译”进离散词表
大 vocabulary 的本质,是提前把更多字符串模式编译成单个离散 symbol。
例如:
internationalization -> [t1]
模型只需要做一次大型 categorical decision: 代价是输出空间变大:
3.2 Sequence axis:把一个大决策拆成多个小决策
小词表可能把同样的字符串拆成:
inter -> nation -> al -> ization
于是原本的一次预测被分解成多个 autoregressive decisions:
也就是说: 一个更大的 tokenizer 会把更多语言结构冻结在 tokenizer 中;一个更小、更组合式的 tokenizer,则把更多结构重新交给 Transformer 在 sequence 中动态建模。
3.3 Depth axis:在一次 token prediction 内部做更多 latent refinement
如果进一步引入 recurrent / looped Transformer,情况就更有意思。
普通 Transformer 可以抽象为:
而 looped Transformer 更像:
同一组 block 被反复迭代,在不线性增加参数量的情况下增加 computational depth。
于是又发生一次复杂度转移:
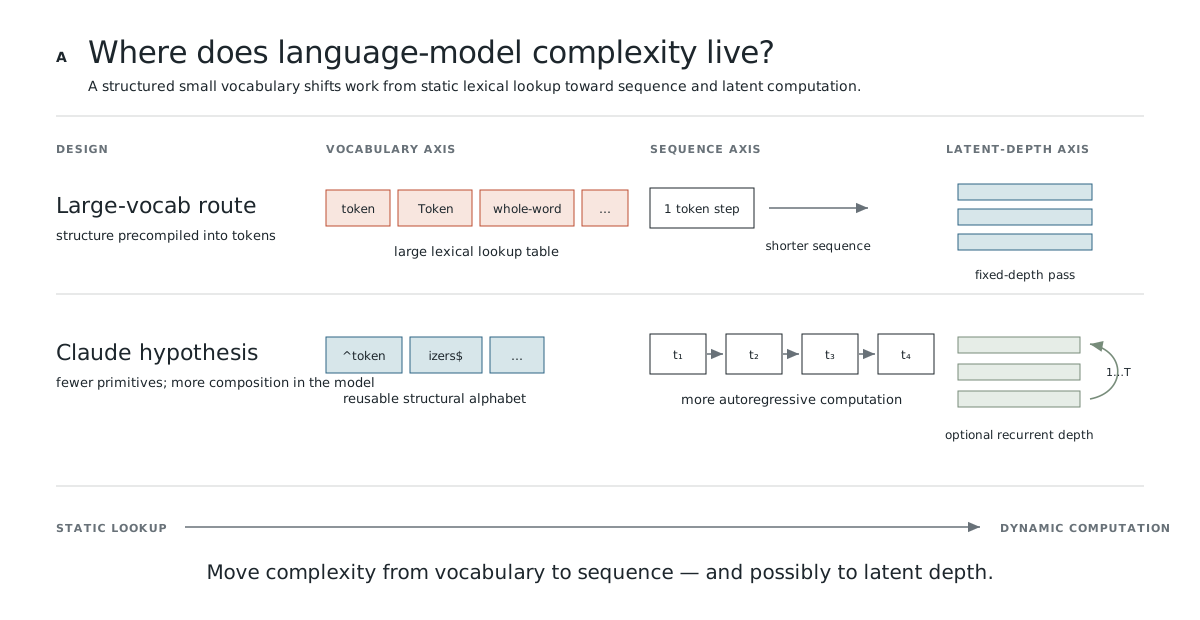 Vocabulary → Sequence → Latent Depth:复杂度迁移示意图
把三条轴放到一起,Claude 4.7+ 的 16K tokenizer 就可以得到一个更激进的解释:
一个可能的核心命题:frontier LLM 是否正在从“用词表压缩语言”,转向“用计算组合语言”?
3.4 一个暂时留下的问题:更多 depth 最后仍要通过同一个 LM head
到这里,我们只建立了一个计算分配视角:small vocab 把一部分复杂度从 vocabulary axis 移到 sequence axis,而 recurrent depth 又可能把更多计算移到 latent-depth axis。
但这会留下一个关键问题:当 backbone 获得更多 iterative reasoning depth 时,最终的输出接口有没有一起扩容?
先不急着回答。下一章先看为什么 recurrent depth 已经从学术假说进入 frontier-model 的现实设计空间;随后再把这个问题与 forward / backward 两种 LM-head bottleneck 放到一起。
#4. Looped Transformer:从 Mythos 猜想到 OpenAI Astra 的现实证据
关于 Claude Mythos 使用 recurrent / looped Transformer,目前仍然没有 Anthropic 官方架构披露。OpenMythos 等社区项目也明确把它标注为 theoretical reconstruction / hypothesis,不代表官方复现。OpenMythos
因此,以下讨论的正确前提仍然是:
假设 Mythos 确实采用某种 recurrent-depth architecture。 但 2026 年 9 月,一个新的行业信号让这个假说值得重新提高权重。
4.1 The Information 报道:Astra 使用 recurrent depth
2026 年 9 月 2 日,The Information 报道 OpenAI 正在准备发布代号 Astra 的新模型。The Information: OpenAI Technique in 'Astra' Model Sparks Security Concerns
- Astra 使用 recurrent depth / looped transformer;
- 同一段 text 会在同一组 layers 上被重复处理;
- 该机制不仅参与训练,也在回答问题时使用;
- OpenAI 还特意限制了 recurrent depth 的使用强度,以保留一定可监控的显式 chain-of-thought。 这意味着 recurrent-depth Transformer 已经从 Universal Transformer、Coconut、LOTUS 一类学术探索,进一步进入了 frontier lab 的现实模型设计空间。
需要注意的是,这条证据对 Mythos 的作用是间接的。
The Information 的报道甚至明确表示,recurrent depth 此前尚未在主要商用 SOTA 模型中公开出现。因此,Astra 不能被当成“Claude 已经使用 looped Transformer”的直接证明,但它确实提高了 ,也让 Mythos 的 recurrent-depth 假说比几个月前更值得认真考虑。
插一句,我正在写一篇关于 Looped Depth: A New Axis of LLM Reasoning——GPT-Astra 的文章,其中会讨论两个可检验的预测:
- 未来同一模型 family 的不同 reasoning-effort 档位,可能共享权重而主要改变 loop-depth budget;它会像 sequence axis 上的 thinking-token budget 一样,成为独立的计算预算。
- Recurrent depth 可能与 latent thinking、以及类似 Coconut / T²MLR 的 sequence-axis hidden-state channel 配套,使可见的 next-token output 与内部计算过程部分解耦。
4.2 如果 Mythos 真是 looped model,为什么 16K vocab 会变得特别有意思?
Looped Transformer 可以通过增加: 获得更多 latent refinement,同时保持: 和: 不变。
也就是说:,但 。
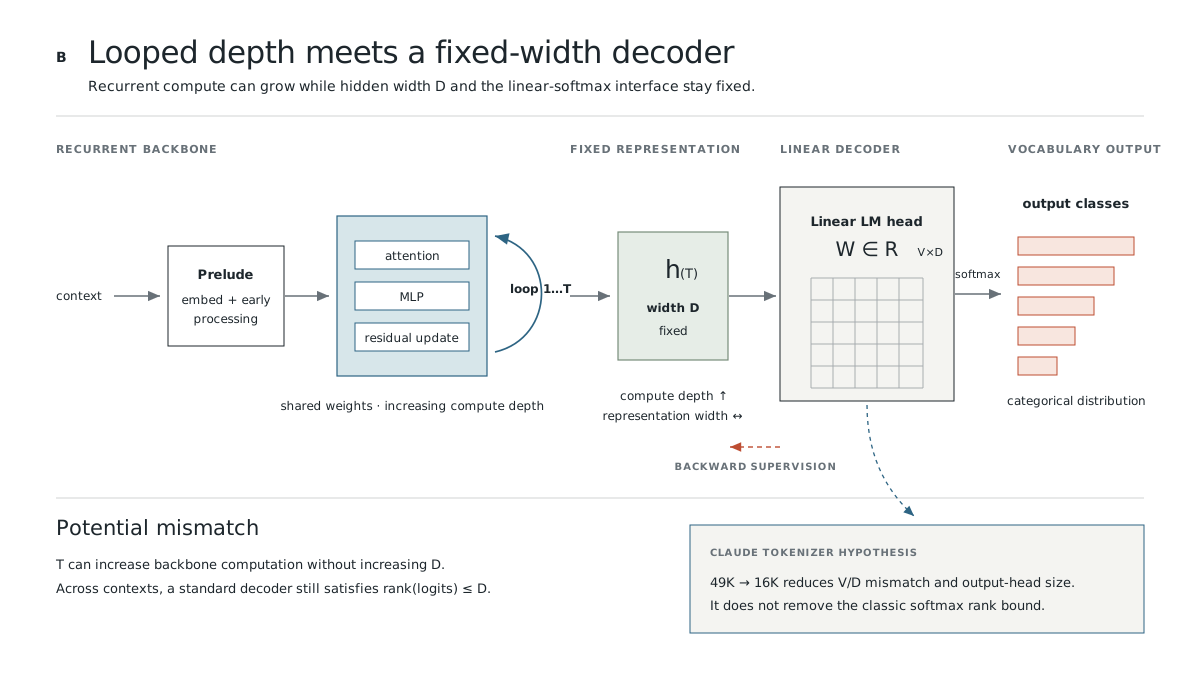 Looped depth 与 fixed-width LM head:depth–decoder mismatch 假说
这在普通 Transformer 中未必特别显眼,因为更强的模型通常同时增加 layers、hidden width 和参数规模;但 recurrent depth 可以把 compute depth 与 representation width 解耦。
于是一个自然的问题出现了:
当 backbone 经过越来越多 latent iterations 后,它是否能够区分越来越细的 contexts,而固定-width linear-softmax decoder 逐渐成为相对更强的瓶颈? 如果答案是“是”,那么: 就可能超出 tokenizer 层面的孤立选择,进一步降低: 让 output space 与 fixed-width hidden state 更匹配。
同时,小词表还会把一个大 categorical decision 拆成更多较小 decision,而每产生一个新 token,模型又获得一次完整的 backbone / recurrent computation。
于是可以得到一个很统一的设计图景:
#5. Looped depth 遇上固定 LM Head:Forward 与 Backward 两种 Bottleneck
前一章给出了一个关键前提:recurrent depth 可以在不增加 hidden width 的情况下继续增加单 token 内部的计算深度。
那么问题就变成:一个越来越强的 backbone,最后仍然必须经过同一个固定接口:
这里存在两个容易混淆、但实际上不同的 bottleneck:
- Forward softmax bottleneck:限制模型最终能够表示怎样的 conditional distribution family;
- Backward gradient bottleneck:讨论 output-space supervision 经过 回传时,哪些方向能够直接到达 hidden state。
5.1 Forward:经典 Softmax Bottleneck
对于很多不同 context,把最终 hidden states 堆成: 标准线性 LM head 给出: 所以必然有: 加入 softmax 的 row-wise normalization 后,log-probability matrix 也只能落在由 维 hidden representation 参数化的低秩 family 中。这就是 Breaking the Softmax Bottleneck 的核心结论。
这不是说一个深思熟虑的 hidden state 被 LM head “丢掉了大部分信息”。 对单个 ,只要 满列秩, 完全可以是 injective。真正受限的是跨大量 contexts 的整组目标分布:无论 backbone 对 contexts 区分得多细,它们最终都必须由同一个 维表示空间和同一套线性 decoder 生成。 因此 looped Transformer 真正可能带来的矛盾集中在另一处: 我把这种潜在的相对失配称作: 这时 vocab size 才真正进入故事。 越大,模型要在一个越大的离散输出空间上表达 context-dependent distributions;把 Claude 的: 看成降低 的操作,至少在几何上是合理的。它不自动解决 softmax bottleneck,但可能让 fixed-width decoder 面对的 output space 更“密集”。
5.2 Backward:同一矩阵在反向传播中形成 Gradient Bottleneck
Forward 的 rank constraint 是一个 expressivity 命题;Backward 讨论的是 supervision 如何穿过同一个矩阵 回到 backbone。
对 cross-entropy loss,logits 上的梯度为:
其中 是预测分布, 是 one-hot target。LM head 再把这个 维误差信号投影回 hidden space:
把 分解成 可见的 row-space component 与正交 component:
那么:
所以 null-space 中的 logit-gradient component 不会直接传进 Transformer hidden state。当 时,这个 null space 的维数至少可以达到 ; 越大,output supervision space 与 hidden space 的几何 mismatch 越显眼。
Lost in Backpropagation: The LM Head is a Gradient Bottleneck 报告,在其分析的模型/训练阶段中,logit gradient 的很大一部分 norm——某些设置约 95–99%——位于这种被 消掉的正交方向。于是它提出:LM head 不只在 forward 限制 distribution expressivity,也可能在 backward 限制 supervision 到达 backbone 的方向。
从这个视角看,Claude 的: 确实非常诱人:在 不变时,它同时缩小 和理论 null-space dimension 。
但这里必须把“几何事实”与“optimization harm”分开。2026 年的 Does the LM Head Create a Harmful Gradient Bottleneck? A Causal Test 保持 tokenizer、正确 target、训练数据与 backbone 不变,只给 output vocabulary 人工加入永远不会成为 target 的类别,把 从 256 扩到 1,024、4,096,使 最大放大约 16×。如果单纯的 rank mismatch 就会严重妨碍训练,validation loss 应该明显变差;实验却没有看到相应退化。
这说明:被投影掉的 gradient norm 很大,并不等价于被投影掉的是有用的 descent signal。 SGD 真正需要的方向可能主要已经集中在 的 row space,或者那些 orthogonal components 对当前参数化本来就不可执行。
因此目前最稳妥的证据等级是:
| 命题 | 状态 |
|---|---|
| Forward | 数学上确定 |
| Backward 会消掉 null-space component | 数学上确定 |
| 实际被消掉的 logit-gradient norm 可以很大 | 已有实验观察 |
| Large vocab 因此系统性伤害 frontier-model optimization | 仍有争议,存在 causal counterexample |
所以 gradient bottleneck 更适合作为 Claude 16K 的 supporting hypothesis,尚不足以充当主因果解释。
5.3 LOTUS:一个必须认真面对的反例
如果上面的故事太顺滑,很容易得到一个过强结论:loop 越深,latent state 越复杂,普通 LM head 就越难读取。 LOTUS 恰恰说明这个推论并不成立。
LOTUS: Bridging the Gap Between Latent and Explicit Reasoning with Looped Transformers 在约 3B 参数规模上构造了 looped Transformer。它没有让模型先生成一长串显式 CoT,改为多次应用同一个 recurrent block,使中间推理发生在 latent hidden states 中。论文报告,在 reasoning benchmarks 上,这种 latent loop 可以接近 explicit CoT,同时减少约 2.5–6.9× 的显式 reasoning latency。
更关键的是它做了一个和本文非常相关的 probe:作者把循环后的 latent state 直接送回原模型的 base LM head,观察这个 head 会解码出什么。结果不是随机乱码。不同 loop 对应的 latent states 往往可以被原 LM head verbalize 成与 gold chain-of-thought 对齐的中间 reasoning step;有时甚至会解码出不在 gold CoT 中、但语义上合理的 alternative intermediate step。
直观地说:
loop 1 hidden state -> LM head -> 一个早期推理步骤
loop 2 hidden state -> LM head -> 更进一步的中间结论
loop 3 hidden state -> LM head -> 接近最终解的 reasoning state
这说明至少在 LOTUS 的训练配方下: 而且这个反例很强:它直接复用原来的语言模型输出头,没有另训一个 probe decoder。也就是说,looped reasoning 完全可能在增加 computational depth 的同时,主动让 hidden states 保持在原有 lexical / verbalizable manifold 上。
但 LOTUS 也不能直接终结本文的假说,因为它的训练目标本身就包含很强的 token-level parallel supervision / latent-to-explicit alignment:模型被明确训练成让不同 loop depth 对齐显式 reasoning tokens。换句话说,LOTUS 的目标之一就是让 latent states 对原 LM head 保持可读。
因此 LOTUS 真正反驳的是强版本命题:
“looped hidden state 天然会跑出 LM head 可表达空间。” 它没有直接反驳更弱、也更值得测试的命题: 当 recurrent depth 在 frontier-scale 模型中继续增加 backbone capacity,而 hidden width 和 linear decoder 不变时,decoder 是否会成为越来越强的 marginal bottleneck?smaller vocab 是否能推迟这种失配? 这也是为什么下面的实验不能只问“latent state 能否被 verbalize”,而应该比较标准 linear head 与更高表达力 decoder 之间的 regret 如何随 loop depth 和 vocab size 变化。
#6. 一个更可检验的命题:Depth–Decoder Mismatch
如果要把“small vocab × looped depth”从有趣故事变成研究假说,关键在于设计一个可以被证伪的实验。
我正在准备使用 Ouro 与 Nanbeige4.2 这两款原生 looped Transformer 进行实验,直接检验下面的 depth–decoder mismatch 预测。
我认为最直接的指标是 Head Regret。
对同一个 recurrent backbone,在不同 loop depth 下得到最终 hidden state: 冻结 backbone,然后分别拟合:
- 标准 linear-softmax head;
- 一个表达能力更强的 nonlinear / Mixture-of-Softmax decoder。 定义: 如果 depth-decoder mismatch 假说成立,则应该观察到: 而且这种增长在 large-vocab 条件下应该更明显。
可以做一个简单的 factorial:
| Small vocab | Large vocab | |
|---|---|---|
| 1 loop / shallow | A | B |
| 8 loops / deep | C | D |
真正值得看的不是 ,而是 interaction: 以及 large-vocab 模型的 是否随着 loop depth 增长得更快。
这直接检验的是:
更多 latent reasoning 是否创造了标准线性 LM head 越来越难充分利用的 representation / target distribution,而 smaller vocabulary 是否推迟了这个 bottleneck? 这比单纯比较 16K 和 48K tokenizer 的 benchmark 更接近本文真正的假说。
#7. Conclusion:Tokenizer 是否正在成为 Reasoning Architecture 的一部分?
单独看 Claude 的新 tokenizer,我们已经有一组不需要假设 Mythos 架构就能成立的解释:
- structural factorization:把空格、边界、大小写等 surface factors 从大量独立 lexical entries 中拆出来;
- 更高的 vocabulary utilization density:更少 slot 被重复 surface variants 占据;
- 从 memorization 转向 composition:减少 long lexical chunks,把更多组合关系交回 Transformer;
- 更密集的训练信号:减少 rare / under-trained / glitch-token long tail;
- 更小的 embedding / LM-head 参数与 logits compute。 这些因素已经足以说明:Claude 的 16K 超出了简单的“压缩词表”,体现出一种不同的 tokenizer philosophy。
但把几个异常信号放在一起,出现了一个更有意思的图景:
- Claude: sharply
- Sequence length:
- Community hypothesis: Mythos recurrent depth?
- OpenAI Astra: recurrent depth reported by credible press 于是,16K vocab 可能已经被纳入一个更大的 architectural trade-off: 传统 tokenizer 的目标之一,是尽可能把常见结构压缩成更少 token;但对于拥有强大 latent computation 的 frontier model,另一种设计哲学可能逐渐变得合理:
不要把太多语言结构固化在一个巨大的离散词表里。保留一个更小、更高利用率的 primitive alphabet,然后让神经网络通过更多 sequence steps 和更多 latent depth 自己去组合。 如果这个方向成立,那么 tokenizer 就不再只是模型前面的“文本压缩器”。
它会开始成为: 而 Claude 的 16K,可能是目前最激进的一次公开信号。
#References / Further Reading
- Sander Land — Reconstructing Claude's tokenizer
- Sander Land — On the Biology of Claude's Tokenizer
- Yang et al. — Breaking the Softmax Bottleneck
- Godey & Artzi — Lost in Backpropagation: The LM Head is a Gradient Bottleneck
- Murugan — Does the LM Head Create a Harmful Gradient Bottleneck? A Causal Test
- Tao et al. — Scaling Laws with Vocabulary
- OpenMythos — community theoretical reconstruction
- The Information — OpenAI Technique in 'Astra' Model Sparks Security Concerns
- Qwen — Qwen3.8-2.4T-A95B config
- Z.ai — GLM-5.2 config; GLM-5.3 uses the same base model
- DeepSeek — DeepSeek-V4-Pro config
- Moonshot AI — Kimi K3 config