从 teacher-centric quality filtering,走向 student-relative residual learning。
训练一个弱 SWE agent 时,目标很清楚:收集正确轨迹,过滤错误动作,然后做 SFT。训练一个已经很强的 agent 时,问题发生了变化。
传统筛选回答的是:这条轨迹好不好?
我们还需要回答另一个问题:这条好轨迹,对当前学生还新不新?
这篇文章的核心观点是:对于已经经过大量 agentic post-training、拥有成熟行为策略的 SWE SLM,数据选择应该从 teacher-centric quality filtering 转向 student-relative residual learning。数据质量不再只是轨迹的绝对属性,而是“数据 × 当前学生 × 学生实际会访问的状态”的相对属性。
SWE-Lego、SWE-Master 等方法仍然是必要的第一层筛选;在此之后,teacher-forced NLL 是一个有效、廉价的第二层指标,可以近似衡量候选轨迹对当前学生还剩多少信息。更进一步,我们不应只在 teacher 已经走完的成功轨迹上训练,还应尽可能从 student rollout、student failure state 和 student pass@k 难度中选择数据,使监督分布更接近部署时真正遇到的状态。
质量筛选决定轨迹是否值得被任何模型学习;残余学习决定其中哪些行为,仍值得被这个学生学习。
#1. 背景:为什么 v14.d 本来应该成功
近一年的 SWE agent 研究给出了一个非常一致的经验:SFT 往往是小模型能力增长中最划算的阶段。SWE-Lego 依靠高质量数据、错误动作 masking 和难度课程,让 Qwen3-8B 与 Qwen3-32B 在 SWE-bench Verified 上达到 42.2% 和 52.6%;Orchard 的 Qwen3-30B-A3B-Thinking 在 SFT 后达到 64.3%,继续加入 RL 后为 67.5%;SWE-Master 也把 teacher rollout、数据清洗、long-horizon SFT、execution-feedback RL 和 inference scaling 组织成一条完整流水线。13
这些结果建立了今天最常见的 teacher-centric 配方:从较新的 issue pool 采样,让强 teacher 在真实容器中 rollout,保留测试通过且协议正确的轨迹,mask 错误或低效动作,再按难度、长度或 reward 组织课程。
v14.d 正是沿着这条路线构建的。它使用 Orchard-SWE 中 MiniMax-M2.5 生成的成功轨迹,最终训练集包含 16,124 条 trajectories、10,551 个 manifest issues:72.8% 来自 Scale-SWE,27.2% 来自 SWE-rebench。筛选要求外部 resolved、协议有效、无 Git 历史泄漏、无测试污染、没有最终未修复的显式自测失败;训练保留完整 thinking 和多轮 observation。2
从传统标准看,这是一份相当理想的数据:真实 issue、真实执行环境、强 teacher、成功轨迹、完整长程上下文。我们预期它会让 Qwen3.5-4B 成为更好的 SWE agent。
#2. v14.d:训练没有坏,策略却没有变好
训练使用 Qwen3.5-4B FullFT、64K context、2 epochs、global batch 32、peak LR 1e-5。W&B API 返回的完整 1,008-step 日志看起来完全正常:update-loss 全程均值为 0.243,最后 50 步为 0.214;held-out loss 从 0.2646 持续降到 0.2541;1,008 个 loss 和 gradient norm 均为有限值。5
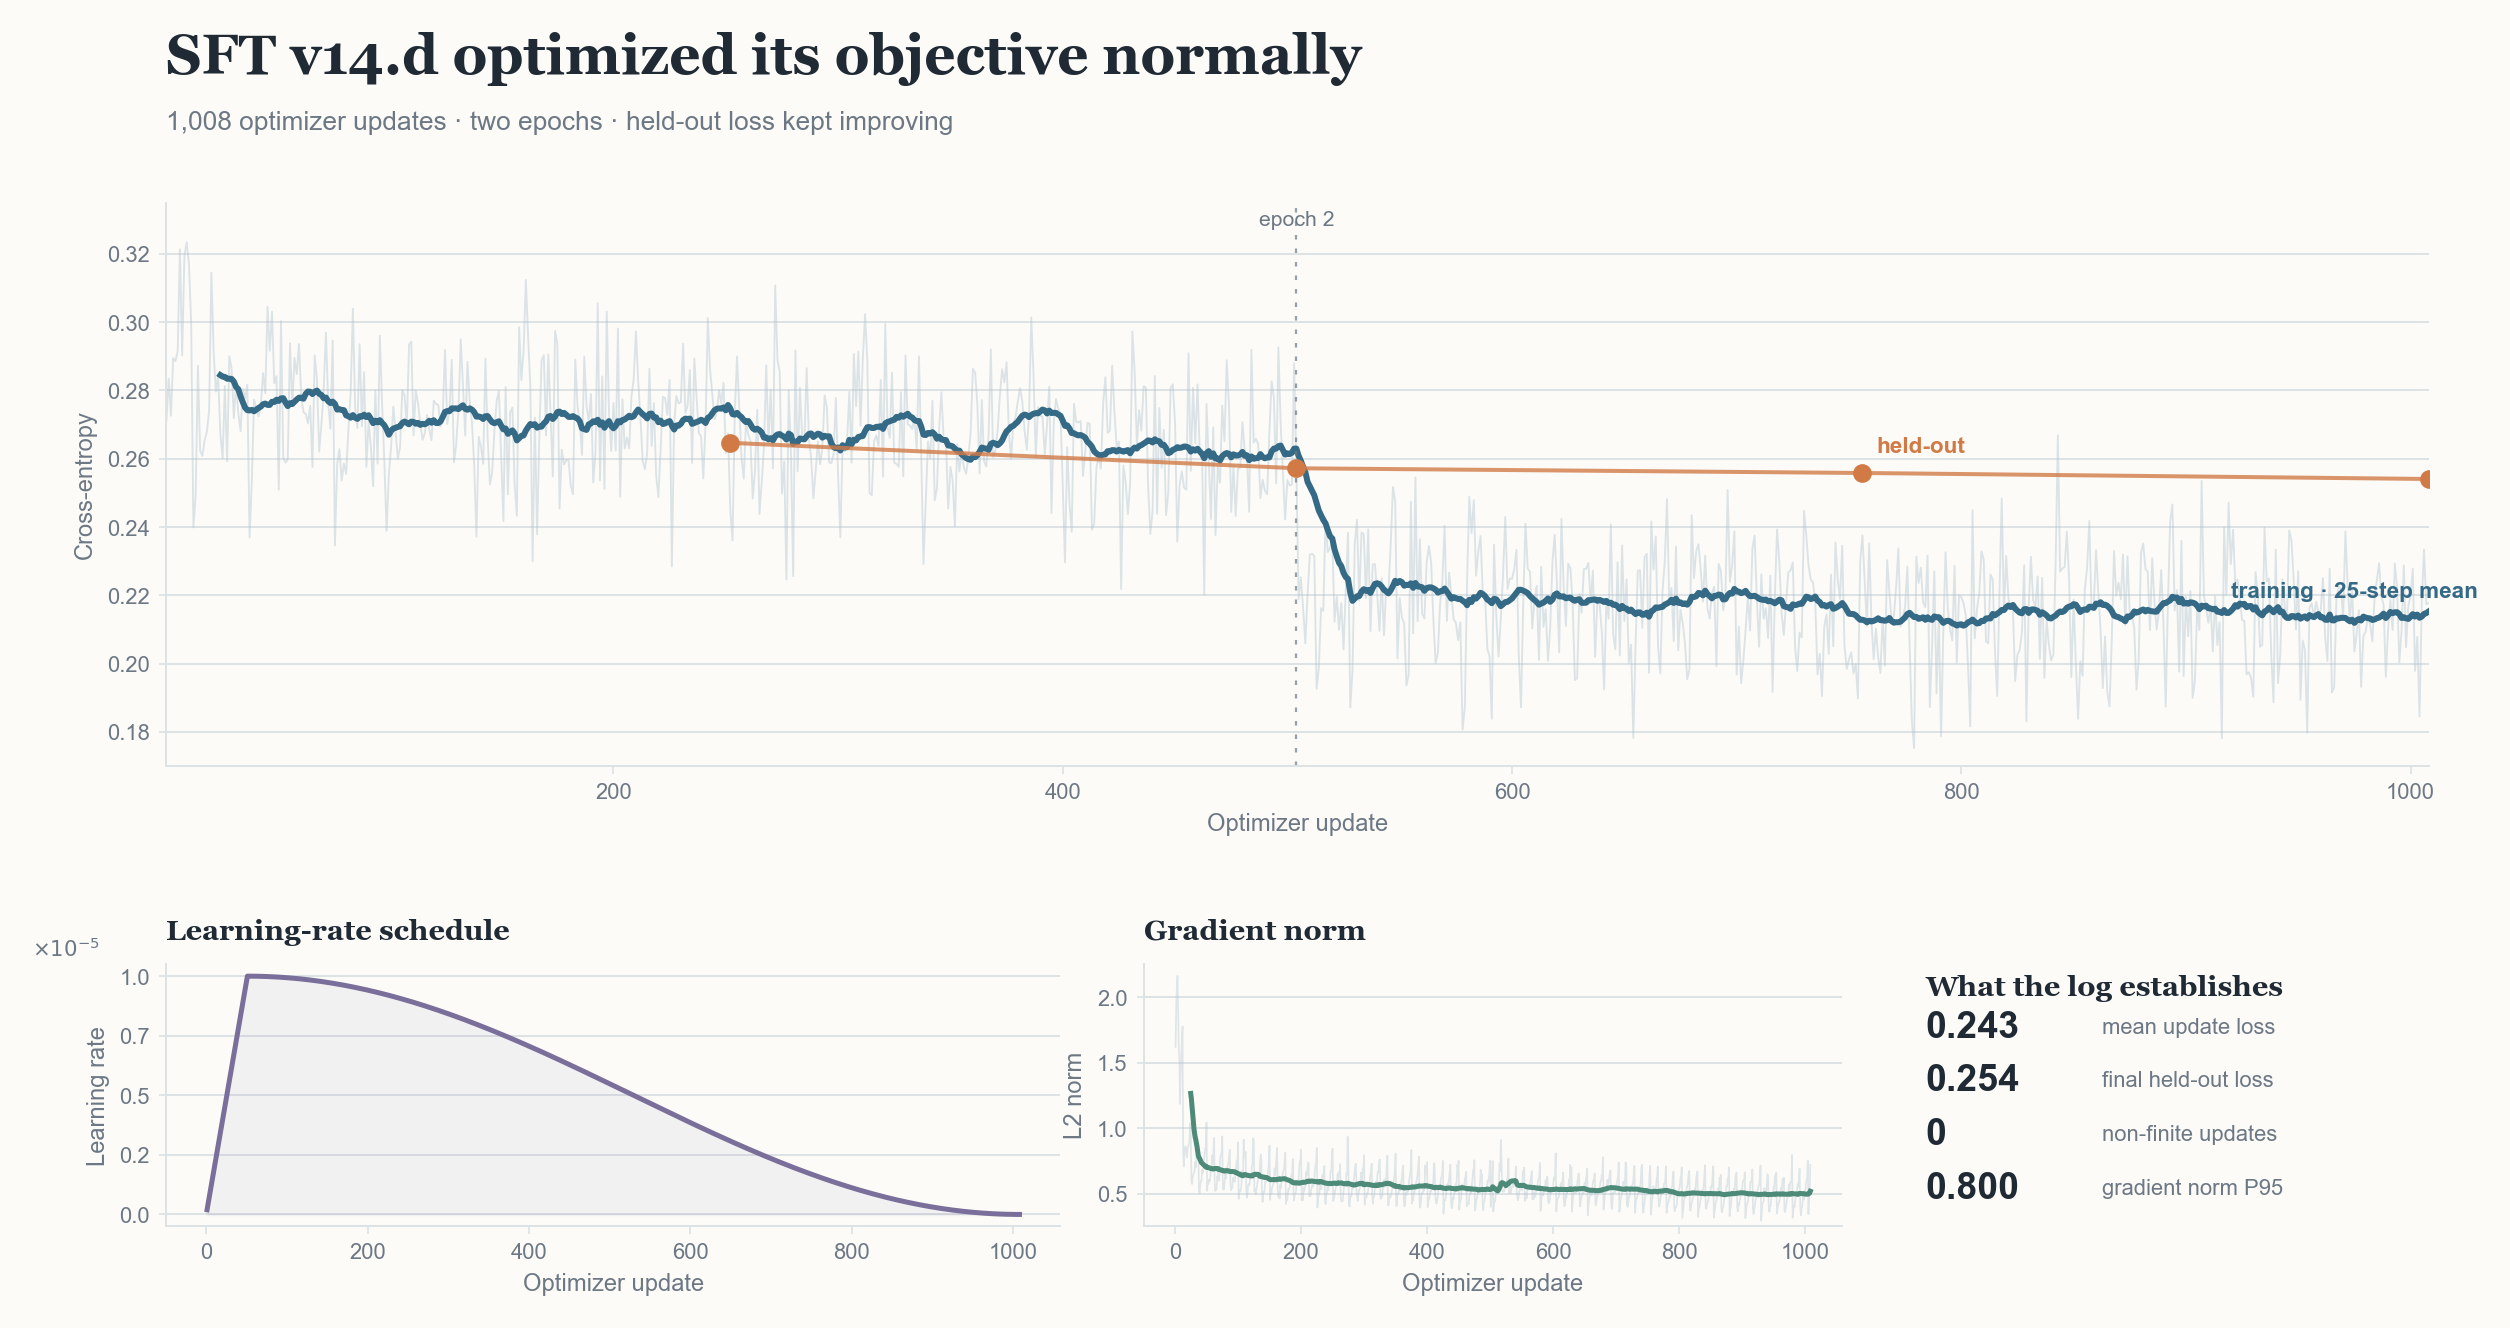 SFT v14.d training log
独立 teacher forcing 也确认模型学到了训练分布:基座在 v14.d train-300 上的 token NLL 为 0.307,SFT 后降至 0.211;validation-256 从 0.300 降至 0.252。15
但闭环结果没有出现预期增益。修复旧评测后,v14.d 在最终 500 题合并结果中严格通过 34.2%,只有 53.6% 的轨迹主动 submit,40.6% 跑满 250 turns。模型更会预测 MiniMax-M2.5,却仍然频繁陷入长程探索、无法收束。6
评测口径。 34.2% 是项目最终合并结果,前 200 题包含选择性重跑,不是统一配置下的一次无偏 pass@1;统一配置的 301–500 题严格通过率为 30.0%。这个限制影响 leaderboard 可比性,但不改变大量 turn-cap 与低 submit 所揭示的行为问题。6
最初的合理怀疑不是“数据对强 student 已经太熟悉”,而是更普通的问题:是不是数据、prompt、chat template、loss mask 或训练配方中藏着一个 bug?
#3. 排除法审计:没有找到能解释结果的训练 bug
我们沿完整链路重新检查了一遍。26
| 审计层 | 检查内容 | 结果 |
|---|---|---|
| 数据选择 | resolved、泄漏与测试污染、train/validation 隔离、冻结 hash | 通过 |
| action protocol | 训练 prompt 与部署 harness 是否都要求单轮单动作 | 通过 |
| chat template | 完整 thinking、多轮 observation 与历史 assistant reasoning 是否保留 | 通过 |
| loss mask | 哪些 token 进入监督,assistant 结束符是否遗漏 | 通过 |
| 优化过程 | loss、held-out loss、gradient norm、checkpoint 与实际 run config | 通过 |
数据协议:v14.c 到 v14.d 只修了一处契约冲突
v14.c 已完成严格的数据选择与全量结构审计,但原始 Orchard 首条 user prompt 仍写着“至少一个 command”,而导出的 mini-swe harness 每轮只接受一个 action。v14.d 没有重新挑选更有利的数据,也没有改写 teacher 行为;它在冻结的 v14.c split 上,把每条轨迹首个 user message 统一改为:恰好一个 <think>...</think>,以及恰好一个 bash block 中的一次 shell action。
重写前后的 issue selection、745,175 个训练 assistant turns、11,624 个 validation assistant turns,以及所有 assistant/observation 内容保持不变。构建器固定 source hash、逐行 fail-closed,并确认 16,124/256 条记录全部完成契约对齐;全量数据仍保留一一配平的 <think>...</think>。26
Chat template 与 loss mask:训练端没有丢历史 reasoning
训练使用实际安装的 MS-SWIFT template,preserve_thinking=true、loss_scale=default。我们把首部样本与序列化最长样本重新编码,逐 token 对比冻结 ChatML 与 trainer 输出;32 条审计样本的 input IDs 和 label mask 全部一致。system、user 与 tool observations 只作为 context;每个 assistant turn 的 reasoning、action 内容和 <|im_end|>\n 都进入 loss。26
这里确实发现过一个 chat-template bug,但它属于旧评测:后续 turn 的 context 丢失了历史 assistant reasoning。修复后的评测保留全部历史 reasoning,而训练数据与训练 loss mask 从未使用那条错误路径。修复后,低 submit 和高 turn-cap 现象仍然存在。6
训练配方:似然目标被稳定优化
最终 run 使用 8×B300、BF16、Flash Attention 2、ZeRO-3、gradient checkpointing、64K no-packing、global batch 32、cosine schedule 与 peak LR 1e-5;这里以 W&B 的真实 run config 为准,而不是以后版本 launcher 的默认值。5 训练、验证与独立 NLL 三条证据都指向同一结论:优化过程稳定,模型也确实更接近 teacher distribution。
这不能证明 v14.d 的每个设计选择都是最优的,但足以排除一个更简单的解释:结果不是因为数据被意外换掉、协议未对齐、历史 reasoning 被训练模板丢弃、loss mask 监督错对象,或 optimizer 数值崩溃。这是一轮实现上正常、目标上成功、闭环行为上不成功的 SFT。
#4. TMax 把单次失败变成了可重复模式
排查到这里,v14.d 仍可能只是一个孤立案例。TMax 提供了更干净的独立对照:同一份 TMax-SFT 数据、相近训练配方,对旧的 Qwen3-8B 有益,却让经过大量后训练的 Qwen3.5-9B 退化。Terminal Bench Lite 上,Qwen3-8B 从 7.3% 提升到 11.5%,Qwen3.5-9B 从 41.9% 降到 35.5%。4
我们用两个模型各自的官方 chat template,在相同 1,000 条 TMax-SFT 轨迹上计算 assistant-token teacher-forced NLL:
| Student | Token NLL | Bits per byte | 相同数据上的 SFT 结果 |
|---|---|---|---|
| Qwen3.5-9B | 0.274 | 0.114 | 41.9 → 35.5 |
| Qwen3-8B | 0.792 | 0.323 | 7.3 → 11.5 |
token NLL 相差 2.89 倍;排除 tokenizer 粒度影响后的 bits per byte 仍相差 2.84 倍。对 Qwen3-8B,这批数据包含明显的新行为;对 Qwen3.5-9B,它已经高度熟悉。同一数据的收益方向随 student 改变,说明“teacher 轨迹质量高”并不足以决定 SFT 是否有效。4
#5. NLL 实验暴露出一个候选黄金区间
NLL 回答的不是“轨迹是否正确”,而是:给定 teacher 已经走出的历史,学生预测下一段 reasoning、action 和停止信号有多困难。
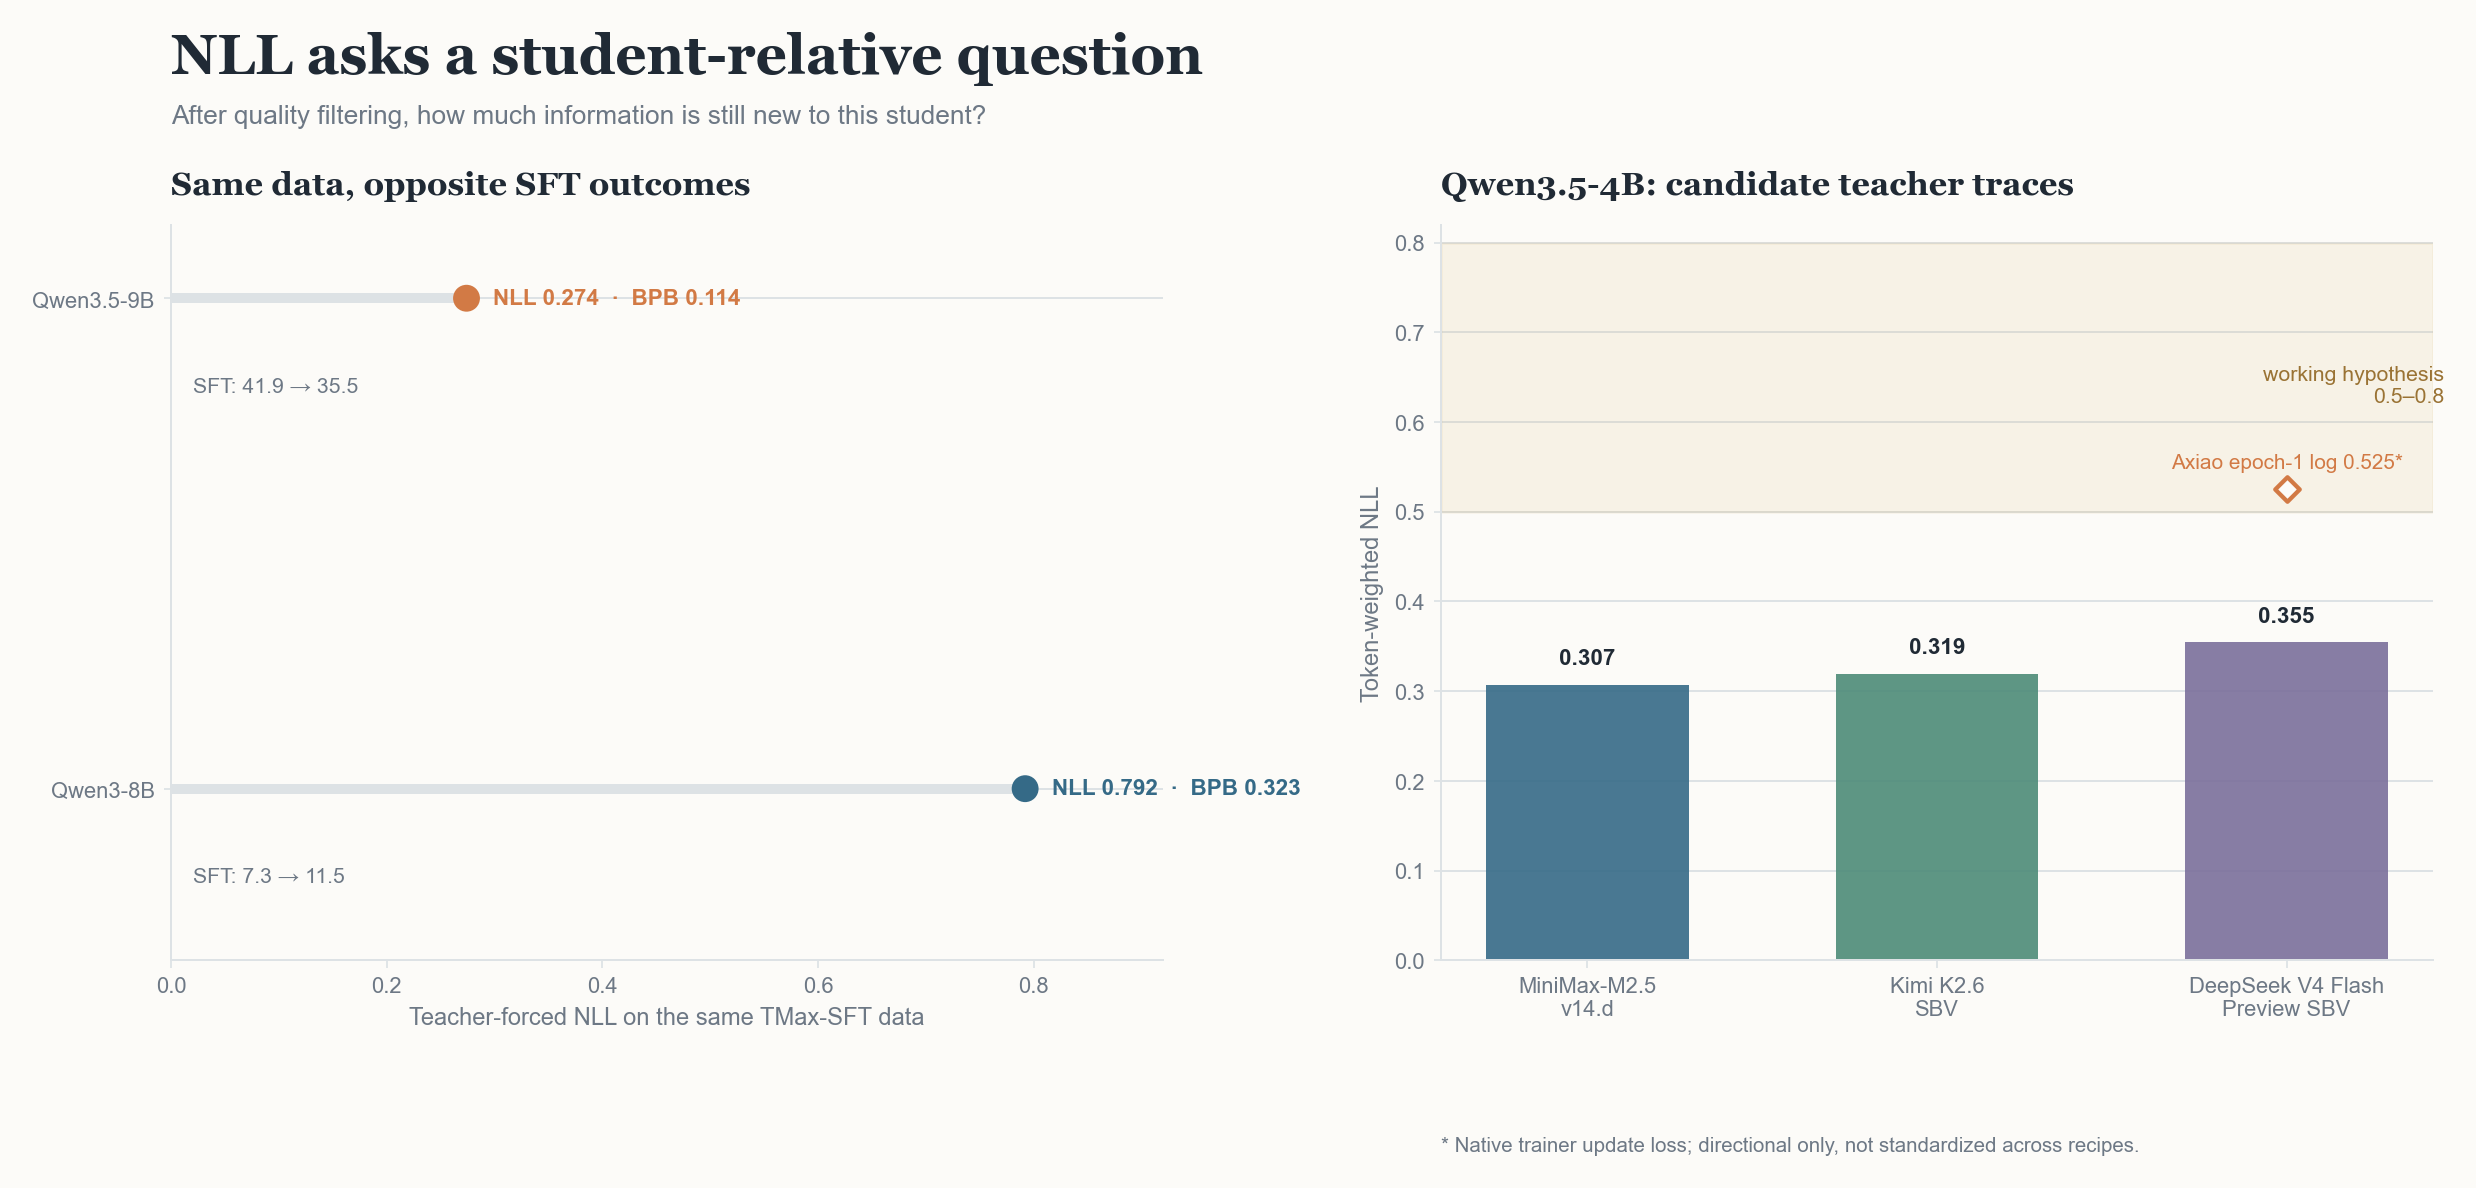 NLL 是学生相对的信息指标
把 v14.d、TMax 和后续 SWE 轨迹实验放在一起,出现了一个值得检验的分层:
| Student × candidate traces | Teacher-forced NLL / 近似训练信号 | 已知训练结果 |
|---|---|---|
| Qwen3.5-9B × TMax-SFT 1K | 0.274 | 41.9 → 35.5(−6.4pp) |
| Qwen3.5-4B × v14.d train-300 | 0.307 | 未获得预期闭环增益 |
| AxiaoDBL Qwen3.5-4B × DeepSeek-V4-Flash GA | 早期 / 首轮约 0.55 | 44.8 → 55.0(+10.2pp) |
| Qwen3-8B × SWE-Lego resolved-500 | 0.738 | 7.6 → 42.2(+34.6pp) |
| Qwen3-8B × TMax-SFT 1K | 0.792 | 7.3 → 11.5(+4.2pp) |
| Qwen3-8B × AgentForge random-500 | 0.812 | 8.0 → 38.2(+30.2pp) |
前三个 Qwen3-8B 结果尤其重要:相同 backbone 下,已知获得收益的数据都聚集在 0.738–0.812。SWE-Lego 与 AgentForge 只看完整未截断轨迹时分别为 0.758 和 0.824,说明截断没有制造这一排序。124
这仍不是一条因果曲线。SWE-Lego 和 AgentForge 的 500 条只是公开 trajectory family 样本,不是完整训练 mixture;训练 recipe、mask、curriculum 和 harness 也不同。AxiaoDBL 的 0.55 是 trainer update-loss,而不是与其余条目严格同口径的离线 token NLL。特别是 AgentForge 的 0.812 已略高于 0.8。因此,当前证据更准确地支持一个以 0.5–0.8 为核心、软上缘约到 0.85 的候选工作区间;“黄金区间”是下一轮实验要证伪的假说,不是定律。
同一份 MiniMax v14.d 数据对 Qwen3-8B 的 NLL 为 0.668,是 Qwen3.5-4B 的 2.17 倍。Qwen3.5-4B 对 Kimi-K2.6 与 DeepSeek-V4-Flash Preview SBV traces 的 NLL 也只有 0.319 与 0.355,但我们没有对应的因果 SFT 结果。1215 这些交叉结果再次说明:NLL 测量的是 student × exact traces,不是 teacher 或 issue pool 的绝对质量。
#6. 为什么 NLL 是一个廉价但不充分的指标
Agentic SFT 并不直接优化 issue resolve。它在 teacher 访问过的历史状态上,最大化 teacher 下一段 reasoning、tool call 与终止动作的似然:
固定数据上的交叉熵近似最小化 ,但只约束 teacher 访问过的 。部署时 student 面对的是自己过去动作诱导出的 ;一次错误搜索或编辑,就可能把它带到 teacher 数据没有覆盖的状态。19
因此,SFT 的能力增益来自接口对齐、行为先验重塑与可复用程序迁移。强 student 可能已经掌握前两项;teacher 的完整长程程序也可能超出它的稳定表达能力。此时,低 training loss 只能证明“更像 teacher”,不能证明“在自己的 rollout 中更会解决问题”。
现有数据筛选方法从不同角度逼近训练价值。SWE-Lego、SWE-Master 和 DEITA 先建立正确、干净的 teacher pool;IFD 用 student likelihood 估计样本难度;LESS 一类方法通过 warm-up 与 per-example gradient influence 估计样本对目标任务的相关性;GRAPE、token rank 与 RSR 则补充 distribution fit 和 informative alignment。1172123
NLL 的优势不是信息最完整,而是成本低、协议直接、适合大规模 preflight:冻结 student 后,只需对候选轨迹做一次无梯度 teacher-forcing forward pass;不需要先训练 warm-up checkpoint,不需要保存逐样本梯度,也不依赖一个额外的 target validation set。它能在昂贵的 rollout 扩展和 FullFT 之前,快速排除“绝对正确、但对当前 student 已高度冗余”的数据。
代价是 NLL 只测 residual information:高 NLL 也可能来自噪声、格式不兼容或 student 无法表达的 teacher policy;最低 NLL 又可能只是 student 已经会。更可靠的目标是在质量门控之后寻找 NLL 适度偏高、关键 token rank 仍合理、并对应 student 真实失败状态 的轨迹。跨模型、tokenizer、template、mask 和领域时,区间都会移动;跨 tokenizer 还应报告 BPB 或 nats/character。
#7. 比 issue source 更关键的变量:rollout teacher
AxiaoDBL 作者说明,其训练 issue pool 是 PrimeIntellect/SWE-Lego-Real-Data-Verified 的子集,rollout teacher 是 DeepSeek-V4-Flash。79 Prime 数据来自 SWE-rebench,并经过测试 ID 修复与 gold-patch F2P/P2P 验证;这是一种高质量的传统筛选。
但 issue pool 并不能解释全部差异。我们对 v14.d manifest 与 Prime Verified 的 4,323 个 resolved issues 做 exact instance-id overlap:
| 重叠口径 | 数量 / 比例 |
|---|---|
| 精确重叠 issues | 1,736 |
| 占 Prime Verified issues | 40.2% |
| 占 v14.d Rebench issues | 61.8% |
| 占 v14.d 全部 manifest unique issues | 16.5% |
| 命中的 v14.d trajectories | 2,635 / 16,124(16.3%) |
完整 overlap 结果与来源 shard 记录见本地实验产物。16
两套训练并非完全不同的 issue 世界;v14.d 已覆盖 Prime pool 的相当一部分。更大的区别是,同类 issues 上生成监督行为的 teacher 不同:MiniMax-M2.5 vs DeepSeek-V4-Flash GA/0731,以及随后的 action masking 与 curriculum 不同。
精确 teacher 版本同样重要。DeepSeek 官方说明,V4-Flash-0731 与 Preview 具有相同架构和规模,主要变化是重新 post-training;但 Terminal Bench 从 61.8 提升到 82.7,NL2Repo 从 39.4 到 54.2,DeepSWE 从 7.3 到 54.4,Toolathlon 从 49.7 到 70.3。10
SWE-Router 的 DeepSeek-V4-Flash SBV traces 在 0731 正式版发布前生成,属于 Preview 时代。12 我们在这份 Preview trace 上测得的 Qwen3.5-4B NLL 是 0.355,不能代替 AxiaoDBL 的 GA teacher 数据。根据作者的社区补充,本稿将 AxiaoDBL teacher 记为 GA/0731 时代;公开 discussion 页面只保留了 DeepSeek-V4-Flash 别名,没有不可变 revision hash。8
这组证据支持一个更强的工程结论:
数据集的单位不是 issue,也不是 resolved trajectory,而是 issue × exact teacher checkpoint × harness × reasoning effort × sampling × loss mask。
一个 benchmark 分数很高的 teacher 不一定能为当前学生提供新能力;同一模型家族的不同 post-training 版本,也可能产生完全不同的训练价值。真正廉价的检验不是看 teacher 名字,而是直接计算学生在候选 teacher traces 上的 NLL。
#8. 从 teacher quality 到 student-relative residual
SWE-Lego 通过执行验证、错误动作 masking 和难度课程提升轨迹质量;SWE-Master 结合 reward、格式、长度、BoN 难度和 LLM judge 过滤;Orchard 进一步用 credit assignment 从失败轨迹中保留有价值的片段。13
这些方法主要解决前三类问题;强 student 还需要加入后两类:
| 维度 | 典型问题 | 典型指标 |
|---|---|---|
| 正确性 | patch 是否真的修好 | F2P / P2P、gold patch validation |
| 过程质量 | 是否包含错误、低效或污染动作 | action mask、格式/长度过滤、LLM judge |
| 问题难度 | issue 对当前 student 是太易、适中还是不可解 | student pass@k、IFD |
| 学生相对信息量 | 当前 student 是否已经熟悉这套行为 | NLL、BPB、token rank、RSR、self-vs-teacher gap |
| 部署状态相关性 | 监督是否覆盖 student 真正会进入的状态 | student rollout prefix、失败状态、行为错误类别 |
正确性和过程质量决定“能不能学”,其余三维决定“值不值得让这个学生学”。上一节的 NLL preflight 只负责廉价定位可能存在的 residual;IFD、LESS、GRAPE、RSR、token rank 与 student pass@k 则继续判断难度、可吸收性、目标相关性和真实状态覆盖。172123
对于较老或已经被广泛训练过的 issue source,还应额外考虑参数记忆和污染风险;较新的 SWE-rebench、Scale-SWE,以及 Prime/SWE-Lego 式二次环境验证,仍然更适合作为上游池。但筛选不应停在这里。NLL 可以删除“绝对正确、相对冗余”的数据;rank 与执行验证可以排除“很惊讶,但其实不可学或错误”的数据;student rollout 则决定这些监督是否对应模型部署时真的会犯的错。
这就是 student-relative residual learning:
不是把最强 teacher 的全部行为压进 student,而是在高质量行为中,寻找并教授 student 当前策略相对于目标策略的可学习残差。
#9. 为什么需要“近似 on-policy”
纯 teacher rollout 是 off-policy 的:teacher 决定看哪些文件、运行哪些命令、进入哪些中间状态,student 只在这些状态上模仿。即使最终 patch resolved,这些状态也未必是 student 执行时最需要帮助的地方。SWE agent 的 horizon 又很长,早期一次分叉足以让后半段 teacher supervision 失去对应关系。
经典 DAgger 的思路是在 learner 自己诱导的状态上查询 expert;语言模型中的 GKD 也让 student 先生成,再由 teacher 在 student-generated sequences 上提供监督,并允许使用不同于固定 forward-KL SFT 的目标。19 对真实 SWE 环境而言,完全 on-policy 的 teacher annotation 成本很高,但可以采用几种近似:
- 先让 student rollout,按 pass@k 和失败类型找到“偶尔成功”或可恢复的 issues;
- 从 student 的失败 prefix、错误 edit 或验证循环开始,让 teacher 纠偏,而不是总从干净初始状态重跑;
- 保留 student 已经正确的动作,只监督 teacher 相对 student 的关键 residual action;
- 训练若干 checkpoint 后重新计算 NLL/rank 并重采样,使数据随 student policy 一起移动。
这些方法并不会自动消除 forward KL 的全部局限,但它们把期望中的状态分布从 推向 :模型开始在“自己真的会到达的地方”学习,监督也更集中于当前策略的缺口。对于已经较强的 agent,这通常比继续扩大静态 teacher-success 数据更接近真正的能力拓展。
#10. 一个廉价的训练前检查
在启动数千条 rollout 或完整 SFT 之前,可以先做下面的 preflight:
- 先做传统质量筛选。 环境可执行、patch resolved、F2P/P2P 有效、无泄漏、动作格式正确。
- 冻结计分协议。 使用待训练的 student checkpoint、实际训练 tokenizer/chat template、完整历史 reasoning 和相同 loss mask。
- 抽样 100–1,000 条候选轨迹计算 NLL。 同时报告 token-weighted mean、逐轨迹分位数和 target-token 数;跨 tokenizer 再报告 BPB。
- 加入学生自己的 rollout 作为锚点。 如果 teacher NLL 接近 self-rollout NLL,新增信息可能有限;如果适度更高、rank 仍合理且轨迹经过验证,它更可能处于可学习的新区域。
- 估计 student-relative issue difficulty。 用 pass@k 区分 always-pass、mixed 和 always-fail;优先检查 mixed issues 与可恢复失败,而不是默认所有 resolved teacher issues 等价。
- 按行为拆分。 单独统计 reasoning、工具动作、第一次有效 edit、验证和 submit;全序列均值可能掩盖少数关键决策。
- 先跑小规模闭环 pilot。 除 pass@1 外,跟踪 submit rate、首次 edit、empty patch、无进展 turns、turn/context cap,再决定是否扩到完整训练。
我们目前会联合使用四组廉价信号:benchmark pass@1/pass@k 衡量学生已有能力;teacher trace NLL 与 token rank 衡量候选监督的新颖度和可吸收性;student rollout 提供自身状态分布的锚点;小规模闭环行为指标检验 teacher forcing 的收益能否转化为真实 rollout。
#11. Next step — Coming soon
下一轮实验会直接检验 residual-learning 假说,而不是继续比较更多 teacher 名字。
实验一:NLL 是否足够,还是需要 informative alignment? 在统一 Qwen chat template、完整历史 reasoning 和相同 loss mask 下,把 assistant targets 拆成 reasoning、tool name/arguments、edit、test/verification 与 submit/termination,逐类计算 NLL、token rank 和 RSR。
实验二:控制质量后的数据分桶。 对相同 issue pool 中通过执行验证的轨迹,按 <0.5、0.5–0.8、0.8–1.1、>1.1 分桶,再在每桶内匹配 assistant token 预算、repo、长度和 teacher。每桶进一步区分低 rank 与高 rank,直接检验 0.5–0.8 是稳定工作区间、柔性边界,还是当前少量实验形成的巧合。
实验三:引入近似 on-policy 的 issue/state selection。 用 student pass@k 将 issues 分为 always-pass、mixed 与 always-fail,并加入从 student failure prefix 出发的 teacher correction。比较静态 teacher-success SFT、student-difficulty filtering,以及 failure-state residual SFT。
实验四:看能力,而不只看 loss。 控制 issue 数、assistant target tokens、repo 分布、训练 steps 与 teacher,除 resolve rate 外,同时测 invalid tool calls、定位与首次有效 edit、reproduction/regression test、premature submit、turn/context cap,并做 checkpoint-level ID/OOD 与 cross-harness 评测。
一个可证伪的预测是:在质量门控之后,中高 NLL、低 token rank、来自 student mixed/failure states 的轨迹,会比单纯最低 NLL、最高 NLL 或随机数据带来更好的闭环收益;提升应首先出现在 student 原有失败模式,而不是只表现为输出格式或长度变化。
#结论
传统 SWE 数据筛选仍然重要,但它只保证轨迹“好”。当目标是拓展一个已经很强的 SWE Agentic SLM 时,我们还必须判断轨迹是否对这个学生有信息、是否可学,以及是否覆盖它实际会进入的状态。
v14.d 展示了一次更值得警惕的失败:16K 条严格筛选的成功轨迹、对齐的协议与 loss mask、稳定下降的训练和验证 loss,仍然没有产生更好的闭环策略。TMax 随后把它从孤例变成模式:同一份 SFT 数据增强 Qwen3-8B,却削弱 Qwen3.5-9B。NLL/BPB 提前暴露了两个学生对数据熟悉度的巨大差异;SWE-Lego、AgentForge 和 AxiaoDBL 的正向结果,则把“0.5–0.8 核心、软上缘约 0.85”变成一个值得直接检验的候选区间。
因此,训练数据的目标不应只是:
找到更多正确轨迹。
而应该变成:
在正确轨迹中,找到当前学生尚未掌握、但有能力学会,并且会在真实 rollout 中用到的那一部分。
这意味着数据工程的重心需要从 teacher-centric quality filtering 继续向 student-relative residual learning 移动。NLL 不是这个问题的最终答案,但它足够便宜、足够直接;与 token rank、student difficulty 和 student-generated states 联合后,它比只看 teacher benchmark、issue source 或训练 loss 更接近我们真正想知道的东西。
#方法说明
- v14.d 的新评测保留所有历史 assistant reasoning;assistant turns 包括格式错误的 action response。Teacher-forced NLL 统计 assistant reasoning、tool-call markup 与 assistant 结束符,system/user/tool response 只作为 context。
- v14.c → v14.d 的数据协议、MS-SWIFT template 与 loss-mask 排查口径见公开审计附录。26
- Claude Opus 4.7 SBV traces 的 assistant turns 与 assistant tokens 异常偏低,可能混入 harness 或采集差异,因此没有进入本文主论证。
- Kimi-K2.6 与 DeepSeek Preview 的 NLL 用于展示 Qwen3.5-4B 对候选 trace distribution 的熟悉度,不代表已经完成对应 SFT 的因果实验。12
- Qwen3-8B 三组 random/resolved-500 结果都使用官方 Qwen3 chat template;loss 只覆盖完整 assistant body、tool call 与结束符。SWE-Lego 与 Open-SWE 的 40,959-token 截断率较高,因此正文同时报告仅未截断 trajectory 的敏感性结果。25
- GRAPE 与 RSR 的公开结果来自通用 instruction tuning 与 reasoning trajectory selection;本文把它们作为 SWE agent 数据选择的动机与待检验假说,而不是现成的 SWE 因果证据。17
- 图表采用直接标注、低饱和配色、轻网格与留白设计,视觉语言参考 Anthropic Transformer Circuits 的研究文章。14
#参考文献
- Tao et al. SWE-Lego: Pushing the Limits of Supervised Fine-tuning for Software Issue Resolving. arXiv:2601.01426, 2026.
- Peng et al. Orchard: An Open-Source Agentic Modeling Framework. arXiv:2605.15040, 2026.
- Song et al. SWE-Master: Unleashing the Potential of Software Engineering Agents via Post-Training. arXiv:2602.03411, 2026.
- Ivison et al. TMax: A Simple Recipe for Terminal Agents. arXiv:2606.23321, 2026.
- 本项目:SFT v14.d W&B run 与 API 核验记录。
- 本项目:v14.d SWE-bench Verified 1–500 最终分布。
- AxiaoDBL. qwen3.5-4b-swebench-sft model card.
- AxiaoDBL. Teacher model and issue pool discussion.
- PrimeIntellect. SWE-Lego-Real-Data-Verified dataset card.
- DeepSeek. DeepSeek-V4-Flash-0731 model card.
- DeepSeek API. Model updates and release history.
- SWE-Router. swebench-verified-deepseek-v4-flash dataset.
- MemoryAsModality. swebench-verified-kimi-k2p6-traces dataset.
- Anthropic Transformer Circuits. Characterizing interference weights in a tiny language model.
- 本项目:v14.d、TMax、Kimi 与 DeepSeek teacher-forced NLL 实验记录。
- 本项目:v14.d × Prime SWE-Lego Verified exact issue overlap。
- Zhang et al. The Best Instruction-Tuning Data are Those That Fit. arXiv:2502.04194, 2025/2026.
- Yang et al. Which Reasoning Trajectories Teach Students to Reason Better? A Simple Metric of Informative Alignment. arXiv:2601.14249, 2026.
- Agarwal et al. On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes. ICLR, 2024.
- Ross et al. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS, 2011.
- Li et al. From Quantity to Quality: Boosting LLM Performance with Self-Guided Data Selection for Instruction Tuning. arXiv:2308.12032, 2023.
- Xia et al. LESS: Selecting Influential Data for Targeted Instruction Tuning. arXiv:2402.04333, 2024.
- Liu et al. What Makes Good Data for Alignment? A Comprehensive Study of Automatic Data Selection in Instruction Tuning. ICLR, 2024.
- Klear Team. Klear-AgentForge: Forging Agentic Intelligence through Posttraining Scaling. arXiv:2511.05951, 2025.
- 本项目:Qwen3-8B × SWE-Lego / AgentForge / Open-SWE random-500 teacher-forced NLL 记录。
- 本项目:v14.d data-protocol 与 loss-mask audit。